
En quelques semaines, j’ai transformé un serveur dédié sous Debian 13 en une plateforme Docker sécurisée capable d’héberger une dizaine d’applications derrière un point d’entrée unique. Ce retour d’expérience détaille l’architecture retenue, les pièges rencontrés et les principes qui rendent l’ensemble reproductible sur une machine vierge.
Pourquoi ce projet
INF est mon serveur d’infrastructure : 16 cœurs, 64 Go de mémoire, quelques téraoctets de disque et une Debian 13 fraîchement installée par l’hébergeur. Mon objectif était d’y déployer des applications conteneurisées sans transformer chaque ajout en chantier, tout en limitant au maximum la surface exposée aux robots qui scannent Internet.
J’ai construit INF comme on consolide une forteresse : couche après couche. D’abord Debian et ses accès, puis Docker, avant de placer Traefik à l’unique point d’entrée. Les applications ne sont venues qu’ensuite, une par une, au rythme des besoins.
Le fil conducteur n’a jamais changé : tout automatiser. Chaque étape est consignée dans des scripts relançables, réunis dans un kit capable de reconstruire l’ensemble sur une machine vierge.
Vue d’ensemble
L’architecture repose sur trois couches : un hôte Debian durci, Traefik comme unique porte d’entrée et des applications qui n’exposent directement aucun port. Ce choix centralise les contrôles réseau et évite qu’une erreur de configuration locale rende un service accessible depuis Internet.
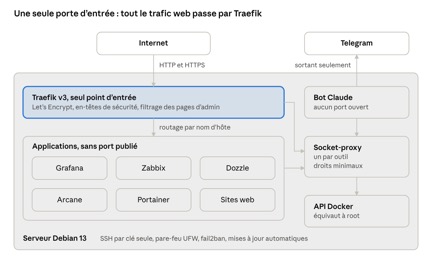
architecture d’INF · un point d’entrée, un socket-proxy par outil
Seul Traefik reçoit le trafic web. Les applications n’ouvrent aucun port, et chaque outil qui lit l’état de Docker, Traefik compris, passe par un socket-proxy qui ne lui accorde que le strict nécessaire.
Étape 1 : verrouiller Debian 13 avant tout le reste
Avant le premier conteneur, j’ai commencé par fermer les portes. Le serveur n’accepte plus que les connexions SSH par clé, n’expose que trois services et applique seul ses correctifs de sécurité. Ce socle paraît moins spectaculaire qu’un tableau de bord Grafana, mais c’est lui qui rend tout le reste défendable.
SSH par clé uniquement. Le durcissement tient dans un fichier dédié sous sshd_config.d, sans toucher au fichier principal : authentification par clé seule, connexion root interdite, un seul compte autorisé, redirections limitées. Le compte à mot de passe fourni par l’hébergeur ne sert plus.
Un filet de sécurité contre l’auto-verrouillage. C’est l’astuce dont je suis le plus content. Le script programme un retour arrière automatique de la configuration SSH au bout de 15 minutes. Si j’arrive à ouvrir une nouvelle session avec ma clé, je confirme et le retour arrière est annulé ; sinon, le serveur revient tout seul à l’état précédent.
Pare-feu UFW. Tout est refusé en entrée, sauf SSH, HTTP et HTTPS.
fail2ban, avec un piège propre à Debian 13. Cinq échecs en dix minutes valent un bannissement d’une heure, qui s’allonge à chaque récidive jusqu’à une semaine. Mais OpenSSH 10, livré avec Debian 13, journalise sous le nom sshd-session, que le filtre de fail2ban 1.1.0 ne reconnaît pas : fail2ban tourne, et ne bannit personne. Trois lignes suffisent à corriger cela :
# /etc/fail2ban/filter.d/sshd.local
[DEFAULT]
_daemon = sshd(?:-session|-auth)?
Mises à jour automatiques. unattended-upgrades applique les correctifs de sécurité et les versions intermédiaires de Debian 13. Je n’active pas le redémarrage automatique : je préfère choisir le moment.
Étape 2 : installer Docker, et se méfier de lui
Une fois l’hôte verrouillé, place à Docker — avec une règle simple : ne jamais confondre simplicité d’usage et sécurité par défaut. Je l’installe depuis le dépôt officiel, après vérification de l’empreinte de la clé de signature, puis trois réglages du démon posent les garde-fous essentiels :
{
« log-driver »: « local »,
« log-opts »: { « max-size »: « 10m », « max-file »: « 5 » },
« ip »: « 127.0.0.1 »,
« live-restore »: true
}
- Avec une limite de 10 Mo par fichier et cinq fichiers conservés, les journaux de chaque conteneur sont plafonnés à environ 50 Mo. Ce réglage réduit fortement le risque qu’un conteneur trop bavard remplisse le disque.
- Un port publié par erreur n’écoute que sur la boucle locale, pas sur Internet.
- Les conteneurs survivent à un redémarrage du démon, ce qui permet de mettre Docker à jour sans couper les services.
Le piège à connaître : les ports publiés par Docker peuvent contourner la politique d’entrée d’UFW. Docker ajoute ses propres règles iptables, qui ne suivent pas nécessairement le chemin de filtrage attendu avec UFW ; un port publié par un conteneur peut donc devenir joignable depuis Internet malgré une configuration UFW restrictive. J’en ai tiré une règle simple : aucune application ne publie directement de port, tout passe par Traefik. Lorsqu’un service de supervision a réellement eu besoin d’un port accessible depuis une seule adresse, j’ai placé le filtrage dans la chaîne DOCKER-USER, prévue pour appliquer des règles avant le trafic des conteneurs, et ajouté un service systemd chargé de les reconstruire avant chaque démarrage de Docker.
Côté organisation, chaque application a son dossier, son compose.yaml et un sous-dossier de secrets aux droits restreints. Quand l’image le permet, les mots de passe sont lus dans des fichiers plutôt que passés en variables d’environnement, et ils ne sont affichés qu’une fois, à la création.
Étape 3 : Traefik, la seule porte d’entrée
À ce stade, il fallait une seule porte d’entrée, facile à contrôler et impossible à contourner par inadvertance. C’est le rôle de Traefik v3 : il reçoit tout le trafic web, tandis qu’une nouvelle application se publie avec quelques labels dans son compose.yaml.
Zéro configuration par application. Un enregistrement DNS joker pointe tous les sous-domaines du serveur vers lui. Le point d’entrée HTTPS est déclaré par défaut avec son résolveur Let’s Encrypt, et HTTP redirige vers HTTPS. Seuls les conteneurs qui le demandent explicitement sont publiés. Il reste donc à écrire ceci :
labels:
– traefik.enable=true
– traefik.http.routers.monapp.rule=Host(`monapp.example.com`)
– traefik.http.routers.monapp.middlewares=admin-ip@file
– traefik.http.services.monapp.loadbalancer.server.port=8080
Le certificat est demandé dès que Traefik voit le routeur, quelques secondes après le démarrage du conteneur, et non au premier visiteur.
Pas d’accès direct au socket Docker. Monter ce socket dans un conteneur lui donne, en pratique, un contrôle équivalent à celui de root sur l’hôte. Traefik passe donc par un socket-proxy placé sur un réseau interne, configuré pour ne lui exposer que les opérations de lecture nécessaires à la découverte des conteneurs et de leurs événements. J’ai reproduit ce schéma pour chaque outil qui interroge Docker, avec un proxy dédié et un périmètre d’accès limité à son besoin.
Des middlewares de sécurité communs. Un fichier de configuration dynamique, rechargé à chaud, les définit une fois pour toutes :
- en-têtes de sécurité sur tous les sites (HSTS d’un an, nosniff, politique de référent, en-tête Server masqué) ;
- TLS 1.2 minimum avec des suites AEAD, et sniStrict pour ne servir aucun certificat à un nom inconnu ;
- rejet des requêtes qui contiennent un caractère nul ou une barre oblique inverse encodés ;
- pour les interfaces d’administration, une liste blanche d’adresses IP, complétée d’un mot de passe bcrypt pour les outils qui n’ont pas leur propre authentification.
Les applications, ajoutées une par une
Une fois le socle stabilisé, ajouter un service est devenu presque routinier : un dossier, un compose.yaml et un script d’installation. Le tableau suivant montre ce qui tourne déjà — et surtout comment chaque application s’insère dans le modèle de sécurité sans créer d’exception.
| Application | À quoi elle sert | Comment on y accède | Accès à Docker |
| Arcane | Gérer conteneurs, piles et images depuis un navigateur | HTTPS, réservé à l’admin | Complet, c’est son rôle |
| Portainer CE | La même chose, version classique | HTTPS, réservé à l’admin | Complet, c’est son rôle |
| Dozzle | Lire les journaux des conteneurs en direct | HTTPS, réservé à l’admin, compte Dozzle | Lecture des journaux |
| Prometheus, Grafana, Node Exporter, cAdvisor, Loki, Promtail, CrowdSec | Métriques, journaux, tableaux de bord, détection d’abus | Seul Grafana est publié | Lecture seule, proxy dédié |
| Zabbix 7.4 et PostgreSQL | Surveiller et prévenir sur Telegram | HTTPS, réservé à l’admin, compte Zabbix | Lecture seule, proxy dédié |
| Bot Claude sur Telegram | Consulter et redémarrer les conteneurs depuis mon téléphone | Aucun port ouvert | Démarrer, arrêter, redémarrer |
| Serveur web nginx et PHP | Héberger un site et déposer ses fichiers en SFTP | HTTPS, et SSH à travers Traefik | Aucun |
| WordPress et MariaDB | Un site public | HTTPS, pages d’admin réservées | Aucun |
Une supervision à deux étages. Prometheus et Grafana fournissent les métriques, les journaux, trente jours d’historique et un tableau de bord préchargé, mais ils ne déclenchent pas d’alerte dans cette installation. Zabbix complète donc ce dispositif : son agent tourne sur l’hôte, où il voit les ressources réelles du serveur, et n’écoute que sur le réseau Docker qui lui est réservé. Enfin, un script relit chaque heure les labels Traefik et crée automatiquement une surveillance HTTPS et du certificat pour chaque site publié. Ainsi, toute nouvelle application rejoint la supervision sans configuration manuelle, et l’arrêt prolongé d’un conteneur déclenche un message en français sur Telegram.
Piloter Docker depuis Telegram, avec Claude. Ce bot Python utilise l’API d’Anthropic et récupère lui-même les messages auprès de Telegram ; aucun port entrant n’est donc nécessaire et Traefik n’intervient pas. Son accès est limité à une liste blanche de comptes Telegram et à un socket-proxy autorisant uniquement la lecture, le démarrage, l’arrêt et le redémarrage des conteneurs. Les garde-fous sont explicites : chaque action doit être confirmée par un bouton, le bot ne peut pas s’arrêter lui-même et Traefik peut être redémarré, mais jamais arrêté. Ce périmètre étroit et prévisible évite de transformer une messagerie en shell root distant.
SSH à travers un reverse proxy, sans aveugler fail2ban. Le serveur web accepte SSH et SFTP par un point d’entrée TCP de Traefik. Problème : derrière un proxy, sshd ne voit que l’adresse de Traefik, et fail2ban ne peut plus bannir personne. Traefik envoie donc le PROXY protocol v2, et go-mmproxy, dans le conteneur, rend l’adresse réelle du client à sshd :
tcp:
serversTransports:
proxy-v2:
proxyProtocol:
version: 2
SSH n’a pas d’équivalent du SNI de TLS, donc chaque conteneur SSH demande son propre point d’entrée. Les comptes « SFTP seul » sont enfermés dans le dossier du site, et le conteneur est jetable : tout son état vit dans des volumes.
Quatre principes qui ont tenu du début à la fin
1. Un kit de scripts relançables. Neuf scripts numérotés, de la sécurisation à Zabbix, lisent un seul fichier de paramètres. Chacun peut être relancé sans dégât : il conserve mots de passe et données, ne recrée que ce qui a changé et s’arrête net, avec un message clair, s’il manque un fichier. Les fichiers générés, comme la configuration de Traefik, sont réécrits par le script à partir de modèles : on modifie le modèle, jamais le fichier sur le serveur.
2. Le moindre privilège partout. Chaque outil dispose de son propre socket-proxy et uniquement des droits nécessaires. Les bases de données restent sur des réseaux internes sans accès à Internet et ne sont joignables que par leur application. Les conteneurs compatibles utilisent l’option no-new-privileges. Une relecture du kit a révélé un écart à ce principe : un minuteur systemd exécuté en root lançait un script stocké dans un dossier appartenant à mon compte. Une modification de ce fichier aurait donc été exécutée en root sans mot de passe sudo. Désormais, les minuteurs utilisent une copie appartenant à root et vérifient cette propriété avant chaque exécution.
3. Des données qui survivent aux nettoyages. Un volume Docker nommé disparaît sur un docker compose down -v, un docker volume prune -a trop généreux ou un clic malheureux dans une interface de gestion. J’ai donc sorti la base de Zabbix de son volume pour la placer dans un dossier de l’hôte, et c’est désormais ma règle pour les données qui comptent. La migration est automatique : copie, contrôle du nombre de fichiers et de la taille, et l’ancien volume n’est jamais supprimé par le script. Le kit programme aussi une sauvegarde de la base chaque nuit, avec quatorze jours de rotation et une commande de restauration qui commence par une sauvegarde de sécurité.
4. Tout est documenté au fil de l’eau. Un guide d’exploitation (accès, dépannage, routine hebdomadaire et mensuelle), un dossier d’architecture qui consigne chaque décision avec les alternatives écartées, et une procédure par application. Chaque nouvelle application ajoute ses lignes aux mêmes tableaux, ce qui garde le tout cohérent.
Les pièges que j’ai rencontrés
Les vraies difficultés ne sont pas venues des grands choix d’architecture, mais de détails minuscules capables de neutraliser une protection ou de bloquer toute une pile. Voici ceux qui m’ont coûté le plus de temps — et les correctifs que j’aurais aimé trouver immédiatement.
| Symptôme | Cause | Correctif |
| Dozzle n’affiche plus aucun journal | La nouvelle image latest du socket-proxy bloque par défaut la lecture des journaux | Ajouter ALLOW_LOGS=1, et figer les versions des images |
| Promtail renvoie des erreurs 403 | Son socket-proxy refusait la liste des réseaux et les journaux | Un proxy dédié avec NETWORKS=1 et ALLOW_LOGS=1 |
| Loki reste « unhealthy » alors qu’il répond | Son image n’a ni wget ni curl : le test de santé ne peut pas s’exécuter | Retirer le test de santé, vérifier /ready depuis un autre conteneur |
| Loki sature au premier démarrage | Promtail rejoue tout l’historique des conteneurs, lignes trop longues comprises | max_line_size_truncate: true |
| Le filtre des pages d’admin WordPress se contourne | Une règle Path ne couvre pas /wp-login.php/x | Une règle PathPrefix |
| Le site WordPress est invisible des moteurs de recherche | L’en-tête X-Robots-Tag: noindexposé pour l’infrastructure s’applique à tous les sites | Un middleware noindex réservé aux interfaces d’admin |
| Tout le script Traefik échoue | Un guillemet en trop dans une ligne ajoutée à la main au compose.yaml | Faire générer cette ligne par le script à partir d’un paramètre |
| D’anciens fichiers restent après une mise à jour du kit | cp -r source destination imbrique le dossier quand la destination existe déjà | cp -r source/. destination/ |
| Dozzle redemande sans fin le mot de passe | Le navigateur gérait mal l’authentification HTTP basique | La page de connexion propre à Dozzle |
Et maintenant
INF n’est pas terminé, et c’est précisément ce que le socle rend possible : l’architecture est assez stable pour accueillir une nouvelle application en une soirée, tandis que les améliorations restantes peuvent être ajoutées sans remettre en cause ses principes. La prochaine étape consiste à renforcer la détection externe, les sauvegardes hors site, le blocage automatisé, l’authentification centralisée et le suivi du cycle de vie des outils.
- Une supervision externe, hébergée ailleurs, avec Uptime Kuma : un serveur ne peut pas signaler sa propre panne.
- Des sauvegardes copiées automatiquement hors du serveur, avec Backrest et restic.
- Passer de la détection au blocage, avec le bouncer CrowdSec pour Traefik.
- Une authentification unique devant les interfaces d’administration, avec TinyAuth ou Authelia.
- Être prévenu des nouvelles versions d’images avec WUD ou Diun, Watchtower étant archivé.
- Remplacer Promtail, en fin de vie, par Grafana Alloy.
Si vous construisez un serveur du même genre, retenez trois principes : centralisez les entrées réseau, ne donnez jamais un accès direct au socket Docker et automatisez chaque étape dans des scripts relançables sur une machine vierge. Les outils changeront ; ces garde-fous, eux, resteront utiles. C’est ce qui transforme un assemblage de conteneurs en une infrastructure que l’on peut comprendre, réparer et faire évoluer. Les scripts et la documentation seront publiés dans un prochain article. Le kit comprendra les neuf scripts d’installation numérotés, le fichier de paramètres central, les modèles de configuration et les services systemd utilisés pour reconstruire INF sur une Debian 13 vierge. La documentation détaillera les prérequis, l’ordre d’exécution, les variables à adapter, les contrôles à effectuer après chaque étape, les procédures de mise à jour, de sauvegarde et de restauration, ainsi que les principaux scénarios de dépannage.